KIMKYUTAE.COM · ©
document.getElementById('current-year').textContent = new Date().getFullYear();
파이썬 코드에서 AI API 호출하고 결과 활용하기
ChatGPT나 Claude에 질문하는 것은 익숙해도, 파이썬 코드에서 AI를 호출하는 일은 처음에는 낯설다. API 키는 어디에 넣는지, 답변은 어떻게 꺼내 쓰는지, 웹 구독과 비용은 어떻게 다른지부터 확인해야 한다.
이 글에서는 파이썬을 조금 사용해본 사람을 기준으로 AI API를 연결하는 과정을 다룬다. 예시는 온라인 쇼핑몰의 고객 문의를 요약하고 배송·환불·기타로 분류하는 작은 프로그램으로 통일했다. 데이터는 모두 연습용이다.
처음에는 OpenAI와 Claude 중 하나만 선택해 질문 하나를 보내보면 된다. 응답을 출력한 뒤 함수를 만들고, 마지막에 프로그램에서 사용할 구조화된 결과를 받아본다.
API의 기본 흐름
API는 프로그램이 다른 서비스에 요청을 보내고 결과를 받는 인터페이스이다. AI API에서는 모델과 입력 내용을 지정해 요청하고, SDK가 HTTP 통신과 응답 처리를 도와준다.
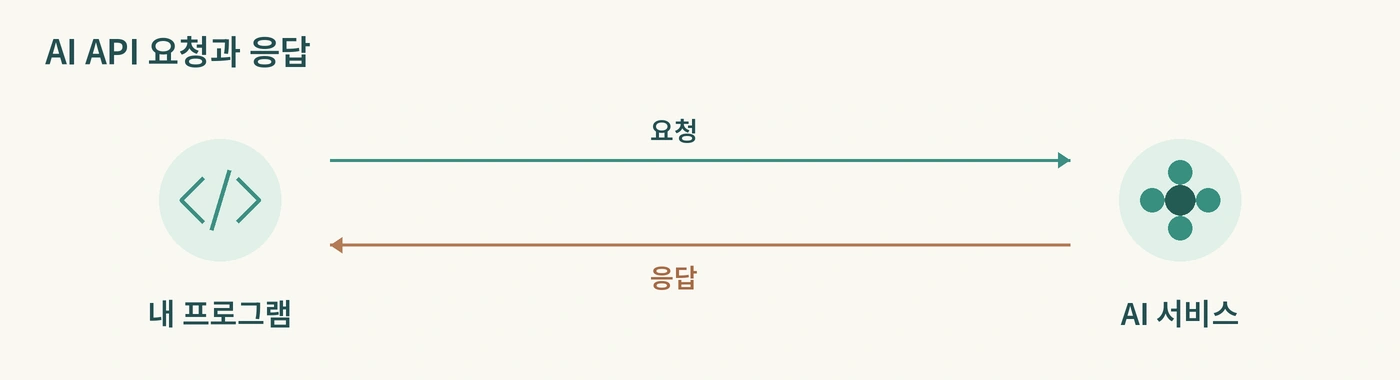
답변은 화면에 출력할 수도 있고, 파일에 저장하거나 다른 함수의 입력으로 사용할 수도 있다. API를 호출했다고 AI가 자동으로 내 파일을 읽거나 주문을 취소하는 것은 아니다. 필요한 데이터와 후속 동작은 프로그램이 명시적으로 다룬다.
계정과 비용
ChatGPT 구독과 일반 OpenAI API 사용료는 별도이다. Claude 웹·앱 구독과 Anthropic API도 구분된다. 웹 서비스에 로그인할 수 있다는 사실만으로 API 키나 사용 가능한 API 잔액이 준비된 것은 아니다.
OpenAI는 개발자 플랫폼, Claude는 Claude 개발자 플랫폼에서 API 사용 환경과 결제 상태를 확인하고 키를 발급한다. 키는 생성 후 안전하게 보관하고, 이 글의 예제에는 자신의 키를 코드에 직접 넣지 않는다.
요금은 모델과 입력·출력 토큰 사용량 등에 따라 달라진다. 토큰은 모델이 텍스트를 처리하는 단위이며 글자 수와 정확히 같지는 않다. 테스트도 과금될 수 있으므로 처음에는 짧은 입력으로 한 번만 호출하고 사용량 화면을 확인한다.
프로젝트 준비
Python 3.10 이상과 VS Code가 설치된 환경을 기준으로 한다. 터미널에서 연습 폴더를 만든다.
mkdir python-ai-api
cd python-ai-api
code .
Mac에서는 다음 명령으로 가상환경을 만든다.
python3 -m venv .venv
source .venv/bin/activate
Windows PowerShell에서는 다음 명령을 사용한다.
python -m venv .venv
.\.venv\Scripts\Activate.ps1
가상환경을 활성화한 뒤 패키지를 설치한다. python -m pip를 사용하면 현재 파이썬 환경에 연결된 pip로 설치할 수 있다.
python -m pip install --upgrade openai anthropic python-dotenv pydanticopenai와 anthropic은 각 서비스의 공식 SDK, python-dotenv는 .env 로딩, pydantic은 응답 구조 정의에 사용한다. 한 공급자만 사용할 예정이라면 다른 공급자의 SDK는 생략해도 된다.
PowerShell에서 가상환경 활성화가 정책 때문에 차단된다면 전역 실행 정책을 바꾸기 전에, 활성화 없이 .\.venv\Scripts\python.exe -m pip install openai anthropic python-dotenv pydantic처럼 가상환경의 파이썬을 직접 실행할 수 있다. 이후 파일 실행에도 같은 경로를 사용한다.
API 키 보관
프로젝트 폴더에 .env 파일을 만들고 사용할 공급자의 키를 넣는다. 아래 값은 실제 키로 바꾸되, 공개하거나 캡처에 포함하지 않는다.
OPENAI_API_KEY=자신의_OpenAI_API_키
ANTHROPIC_API_KEY=자신의_Anthropic_API_키
같은 폴더의 .gitignore에는 다음 내용을 넣는다.
.env
.venv/
__pycache__/load_dotenv()가 .env의 값을 환경변수로 읽으면 SDK가 OPENAI_API_KEY 또는 ANTHROPIC_API_KEY를 사용한다. 환경변수가 이미 설정되어 있다면 기본적으로 그 값이 우선한다.
.env는 암호화된 비밀 저장소가 아니라 일반 텍스트 파일이다. .gitignore도 이미 Git에 기록된 키를 지워주지는 않는다. 키가 노출됐다면 공급자에서 폐기하고 새 키를 발급해야 한다. 브라우저로 전달되는 자바스크립트에는 API 키를 넣지 않고 서버에서 호출한다.
OpenAI 첫 호출
openai_test.py를 만들고 다음 코드를 저장한다.
from dotenv import load_dotenv
from openai import OpenAI

load_dotenv()
client = OpenAI(timeout=30.0, max_retries=2)

response = client.responses.create(
    model="gpt-6-luna",
    input="다음 문의를 한 문장으로 요약해줘: 주문한 상품이 아직 도착하지 않았어요.",
    max_output_tokens=500,
)

print(response.output_text)
python openai_test.pymodel은 API 모델 ID, input은 입력 내용이다. response.output_text에서 텍스트를 꺼낸다. 예를 들어 ‘주문한 상품의 배송 지연에 대한 문의’처럼 출력될 수 있지만 문장은 실행할 때마다 달라질 수 있다.
timeout은 요청이 무한정 대기하지 않도록 하고, max_retries는 SDK의 재시도 횟수를 제한한다. max_output_tokens는 출력 토큰의 상한이다. 지원 모델에 따라 추론 토큰도 이 예산에 포함될 수 있어 너무 낮게 설정하면 답변이 완성되지 않을 수 있다.
예제의 모델을 사용할 수 없다면 공식 모델 목록과 계정 접근 권한을 확인한다. 모델 ID와 웹 화면의 표시 이름은 구분해야 한다.
Claude 첫 호출
Claude를 선택했다면 claude_test.py에 다음 코드를 저장한다.
from dotenv import load_dotenv
from anthropic import Anthropic

load_dotenv()
client = Anthropic(timeout=30.0, max_retries=2)

response = client.messages.create(
    model="claude-sonnet-5-5",
    max_tokens=1024,
    messages=[{
        "role": "user",
        "content": "다음 문의를 한 문장으로 요약해줘: 주문한 상품이 아직 도착하지 않았어요.",
    }],
)

texts = [block.text for block in response.content if block.type == "text"]
print("\n".join(texts))
python claude_test.pyClaude Messages API는 messages에 대화를 전달하고 max_tokens로 출력 상한을 지정한다. 응답의 content는 블록 목록이므로 텍스트 블록만 골라 합친다. OpenAI 응답의 output_text와 같은 속성으로 읽으면 안 된다.
모델은 Claude 공식 모델 목록에서 확인한다. 출력이 중간에 끝나면 stop_reason과 출력 상한을 함께 살펴본다.
함수로 분리하기
기존 프로그램에 연결할 때는 호출 부분을 함수로 분리하면 편하다. inquiry_summary.py에는 다음과 같이 작성할 수 있다.
from dotenv import load_dotenv
from openai import OpenAI

load_dotenv()
client = OpenAI(timeout=30.0, max_retries=2)


def ask_openai(question: str) -> str:
    response = client.responses.create(
        model="gpt-6-luna",
        input=question,
        max_output_tokens=500,
    )
    return response.output_text


if __name__ == "__main__":
    inquiry = "어제 상품을 받았는데 크기가 맞지 않아 환불하고 싶어요."
    question = f"""아래 고객 문의를 한 문장으로 요약해줘.
문의에 없는 사실은 추가하지 마.
<inquiry>
{inquiry}
</inquiry>
"""
    answer = ask_openai(question)
    print(answer)
프로그램이 가진 inquiry 변수를 질문에 넣고, 응답을 answer에 저장한다. 이후에는 문의를 파일이나 데이터베이스에서 읽어오는 부분만 추가하면 된다.
문의 내용은 분석 대상 데이터이며 프로그램의 지시문이 아니다. 실제 서비스에서는 문의 안에 ‘앞의 지시를 무시하라’ 같은 문구가 들어올 수 있다. 입력을 구분해 전달하는 것만으로 모든 문제가 해결되지는 않으므로, 응답을 검증하고 실행 권한을 제한해야 한다.
구조화된 결과
요약문을 사람이 읽는 데는 문자열이면 충분하다. 프로그램이 배송·환불·기타에 따라 처리 경로를 나누려면 정해진 구조로 받는 편이 낫다.
{
  "category": "refund",
  "summary": "상품 크기가 맞지 않아 환불을 요청함"
}
단순히 ‘JSON으로 답해줘’라고 요청하는 것과 API의 구조화된 출력 기능은 다르다. 여기서는 Pydantic 모델로 필드와 허용 값을 정의한다. 형식이 맞는다고 분류 내용까지 항상 정확하다는 뜻은 아니다.
OpenAI 구조화 출력
openai_structured.py에 다음 코드를 저장한다. 예제는 실제 환불을 실행하지 않고 검토 경로만 출력한다.
from typing import Literal

from dotenv import load_dotenv
from openai import OpenAI
from pydantic import BaseModel

load_dotenv()
client = OpenAI(timeout=30.0, max_retries=2)


class InquiryResult(BaseModel):
    category: Literal["delivery", "refund", "other"]
    summary: str


response = client.responses.parse(
    model="gpt-6-luna",
    input=[
        {
            "role": "system",
            "content": "고객 문의를 분류하고 한 문장으로 요약한다. "
                       "배송은 delivery, 환불은 refund, 나머지는 other이다. "
                       "문의에 없는 사실은 추가하지 않는다.",
        },
        {
            "role": "user",
            "content": "받은 상품의 크기가 맞지 않아 환불하고 싶어요.",
        },
    ],
    text_format=InquiryResult,
    max_output_tokens=1000,
)

result = response.output_parsed
if result is None:
    raise RuntimeError("구조화된 결과를 받지 못했습니다. 응답 상태와 거절 여부를 확인하세요.")

print(result.category)
print(result.summary)
if result.category == "refund":
    print("환불 담당자의 검토 목록에 추가")
category를 일반 str 대신 Literal로 정의해 허용 값을 제한했다. 응답이 거절되거나 완료되지 않을 수 있으므로 output_parsed가 있는지도 확인한다.
Claude 구조화 출력
claude_structured.py에는 다음처럼 작성한다. 최신 anthropic SDK와 구조화된 출력을 지원하는 모델이 필요하다.
from typing import Literal

from dotenv import load_dotenv
from anthropic import Anthropic
from pydantic import BaseModel

load_dotenv()
client = Anthropic(timeout=30.0, max_retries=2)


class InquiryResult(BaseModel):
    category: Literal["delivery", "refund", "other"]
    summary: str


response = client.messages.parse(
    model="claude-sonnet-5-5",
    max_tokens=1024,
    system="고객 문의를 배송 delivery, 환불 refund, 기타 other로 분류하고 "
           "한 문장으로 요약한다. 문의에 없는 사실은 추가하지 않는다.",
    messages=[{
        "role": "user",
        "content": "받은 상품의 크기가 맞지 않아 환불하고 싶어요.",
    }],
    output_format=InquiryResult,
)

result = response.parsed_output
if result is None:
    raise RuntimeError("구조화된 결과를 받지 못했습니다. 종료 사유를 확인하세요.")

print(result.category)
print(result.summary)
OpenAI는 text_format과 output_parsed, Claude는 output_format과 parsed_output을 사용한다. 비슷한 기능이지만 인자와 응답 속성은 다르다.
코드와 AI의 역할
배송비 계산, 주문 수량 합계, 주문 상태 조회는 기존 코드가 처리하는 편이 낫다. AI에는 자유롭게 적힌 문의의 의미를 읽거나 요약하는 일을 맡긴다.
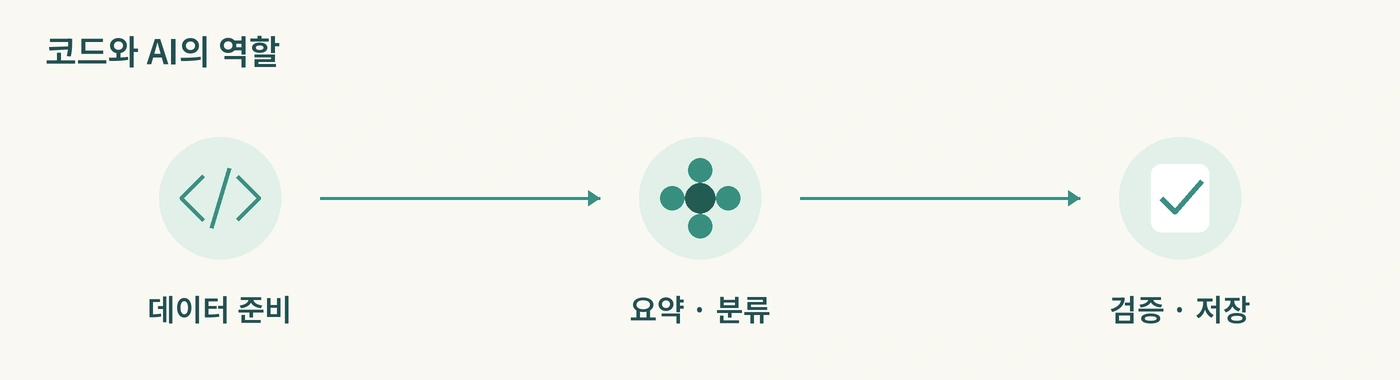
예를 들어 주문 데이터는 코드로 조회하고, 개인정보를 제거한 문의 내용만 AI에 보낸다. AI의 분류 결과를 검토 목록에 기록한 뒤 실제 환불 여부는 주문 상태와 환불 정책에 따라 결정한다.
AI가 refund라고 분류했다는 이유만으로 결제 취소 API를 바로 호출하지 않는다. 처음에는 분류 정확도를 사람이 확인할 수 있는 흐름으로 시작하는 것이 좋다.
반복 호출과 비용
문의 1,000건을 한 건씩 반복 호출하면 요청도 1,000회 발생한다. 같은 데이터를 재처리하지 않도록 결과를 저장하고, 빈 문의나 이미 처리한 건은 코드에서 제외한다.
예를 들어 전체 문의 1,000건 중 아직 처리하지 않은 80건만 선택해 호출할 수 있다. 이는 흐름을 설명하기 위한 예시 숫자이며 비용 예상값은 아니다.
입력 길이와 출력 상한, 동시 요청 수를 제한하고 사용량을 기록한다. SDK 재시도에 별도 반복 재시도까지 겹치면 예상보다 많은 요청이 나갈 수 있다. 예산 알림과 실제 호출 차단이 같은 기능이라고 가정하지 말고, 공급자의 설정과 프로그램 자체 호출 한도를 확인한다.
오류 처리
외부 API는 항상 성공하지 않는다. 오류를 빈 문자열로 바꾸면 ‘응답이 없는 상태’와 ‘호출에 실패한 상태’를 구분하기 어렵다. 호출한 쪽에서 실패 상태를 기록하고 재처리 여부를 정하는 편이 낫다.
from openai import (
    APIConnectionError,
    APIStatusError,
    APITimeoutError,
    AuthenticationError,
    RateLimitError,
)

# 앞의 inquiry_summary.py와 같은 폴더에 error_test.py로 저장한다.
from inquiry_summary import ask_openai

try:
    answer = ask_openai("상품 배송이 늦어진다는 문의를 한 문장으로 요약해줘.")
    print(answer)
except AuthenticationError:
    print("API 키와 접근 권한을 확인하세요.")
except RateLimitError:
    print("요청 제한 또는 사용 가능한 한도를 확인하세요.")
except APITimeoutError:
    print("요청 시간이 초과되었습니다. 나중에 다시 처리할 건으로 남깁니다.")
except APIConnectionError:
    print("네트워크, 프록시, 연결 상태를 확인하세요.")
except APIStatusError as exc:
    print(f"API 응답 오류: HTTP {exc.status_code}")
앞의 함수 예제는 실행 부분을 if __name__ == "__main__": 아래에 두었다. 따라서 다른 파일에서 ask_openai를 import해도 예제의 API 호출이 자동으로 한 번 더 실행되지 않는다.
인증 실패는 키나 권한을 고치기 전까지 반복해도 해결되지 않는다. 429 응답은 요청 속도 문제인지 사용 한도 문제인지 구분한다. 일시적인 연결 오류나 서버 오류에는 횟수가 제한된 재시도를 고려하되, 원문과 키를 오류 로그에 남기지 않는다.
보낼 데이터 점검
고객 문의에는 이름, 전화번호, 주소, 주문번호가 들어갈 수 있다. 요약에 필요 없는 정보는 전송 전에 제거한다. 필요하면 고객 이름을 CUSTOMER_001 같은 식별자로 치환하고, 원본과의 대응표는 프로그램 내부에만 둔다.
식별자 치환만으로 완전히 익명화되는 것은 아니다. 문의 문맥이나 다른 정보로 개인을 추정할 수 있고, 치환 후 AI가 원문을 정확히 복원해줄 수도 없다. 모델 응답을 임의로 치환해 복원하기보다 원본 고객 정보와 AI 요약을 내부 데이터에서 연결한다.
회사 데이터라면 사용 가능한 공급자와 계정, 데이터 보관 조건, 계약과 내부 정책을 확인한다. 공개용 예제나 초기 테스트에는 실제 고객 데이터 대신 가상 데이터를 사용한다.
처음 적용할 때
처음부터 여러 공급자와 복잡한 자동화 구조를 만들 필요는 없다. 한 번 호출해 답을 받고, 입력을 변수로 바꾸고, 필요할 때 구조화된 출력과 오류 처리를 추가하면 된다.
공급자를 바꿀 가능성이 있다면 API 호출 함수를 별도 모듈로 두고 나머지 프로그램은 그 함수를 사용하게 한다. 같은 함수 인터페이스를 사용하더라도 모델별 응답 품질과 오류 동작은 다시 검증해야 한다.
작은 샘플에서 요약과 분류 결과를 확인한 다음 호출량을 늘리는 편이 수정하기 쉽다. API 연결이 성공했는지와 프로그램이 믿고 사용할 수 있는 결과인지도 따로 확인한다.
참고 문서
OpenAI 구조화된 출력 · GPT-6 Luna 모델 · Claude 구조화된 출력 · Claude 모델 목록
팁: AI 도우미 활용
코드나 환경 설정이 어렵게 느껴진다면 VS Code의 Codex나 Claude Code 같은 AI 코딩 도우미를 활용해도 된다. 가상환경 생성, 패키지 설치, 예제 파일 작성, 오류 원인 확인을 단계별로 요청할 수 있다. 모든 명령을 외우기보다는 어떤 설정을 바꾸는지 설명을 듣고 작은 단계로 진행하는 편이 이해하기 쉽다.
현재 프로젝트에서 파이썬으로 OpenAI API를 처음 연동하려고 해.
먼저 운영체제와 파이썬 설치 상태를 확인해줘.
가상환경을 만들고 필요한 패키지를 설치한 뒤,
가상의 고객 문의를 한 문장으로 요약하는 예제 파일을 작성해줘.
API 키는 내가 직접 .env에 넣을 테니 키를 요청하거나 출력하지 마.
각 단계에서 무엇을 바꾸는지 설명하고, 마지막에 실행 방법을 알려줘.
Claude API를 사용한다면 요청문의 OpenAI를 Claude로 바꾸면 된다. AI가 만든 코드는 직접 확인하고, 실제 호출은 짧은 테스트 한 건부터 진행한다. 호출에는 비용이 발생할 수 있으며, 도우미가 .env를 읽거나 키를 로그에 남기지 않도록 해당 파일을 작업 대상에서 제외하고 실행 내용을 확인한다.